زیرساخت و توسعه
متا فاز نخست ابرخوشهٔ گیگاواتی Prometheus را تکمیل کرد
این زیرساخت در نیو آلبنی اوهایو، با صدها هزار GPU، برای آموزش مدلهای Muse بهکار رفته و متا میگوید قصد دارد آن را به حدود یک میلیون GPU گسترش دهد.
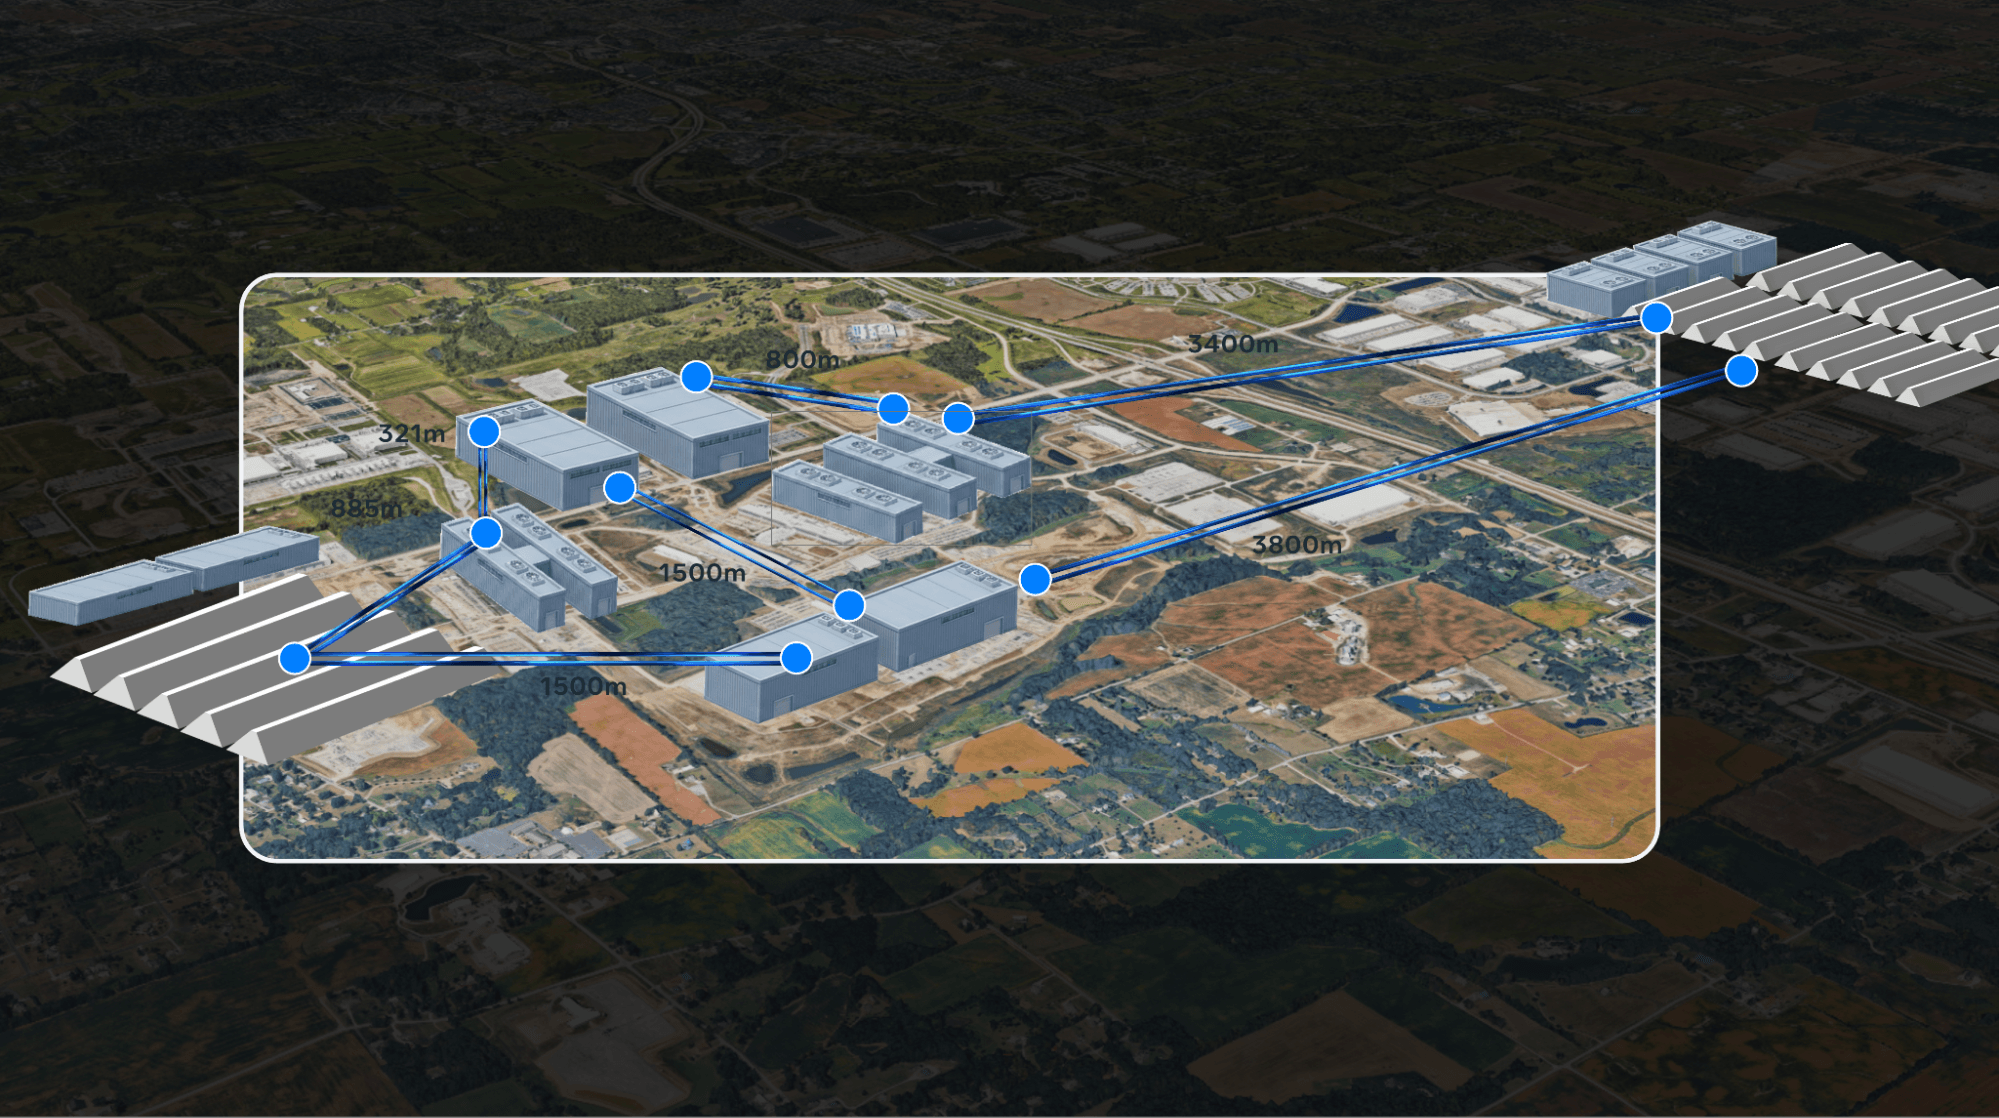
متا میگوید فاز نخست ابرخوشهٔ هوش مصنوعی Prometheus در مرکز دادهٔ این شرکت در نیو آلبنیِ اوهایو تکمیل شده است. این مجموعه برای آموزش نسل بعدی مدلهای بنیادی متا ساخته میشود و فاز نخست آن در آموزش مدلهای Muse، از جمله مدلهای Muse Wonder، بهکار رفته است.
Prometheus اکنون صدها هزار GPU را در چند ساختمان به هم متصل میکند؛ ساختمانهایی با طراحی متعارف یا بهینهشده برای هوش مصنوعی و سازههایی که سریعتر راهاندازی میشوند. شبکهای از فیبر نوری این مجموعه را به هم پیوند میدهد تا اجزای آن مانند یک ماشین واحد کار کنند. متا میگوید در مقیاس کامل، این ابرخوشه حدود یک میلیون GPU خواهد داشت.
به گفتهٔ متا، در اجرای پیشآموزش Muse Wonder بیش از ۸۵ درصد و در اجرای یادگیری تقویتی آن بیش از ۹۰ درصد «goodput» به دست آمده است؛ معیاری برای سنجش سهم زمان اجرای مفید آموزش. میانگین زمان کارکرد GPU بین وقفهها حدود ۴۷ هزار ساعت بوده و اصلاحات بعدی، از جمله بهروزرسانی firmware، این رقم را به بیش از ۵۴ هزار ساعت رسانده است.
Prometheus اکنون از دو پلتفرم GPU شرکت NVIDIA استفاده میکند و متا میگوید پلتفرم سومی مبتنی بر Vera Rubin NVL72 نیز بهزودی به آن اضافه خواهد شد. این شرکت در حال گسترش مجموعه برای آموزش مدلهای آیندهٔ Meta Superintelligence Labs است.
این گزارش به کمک هوش مصنوعی تهیه شده است. مطالب براساس منابع درجشده تنظیم شدهاند؛ صحت مستقل همه ادعاها تضمین نمیشود.
منبع: Meta Engineering — مشاهده منبع اصلی ↗
رد این داستان در رادار
خبرهای مرتبط از آرشیو منتشرشده